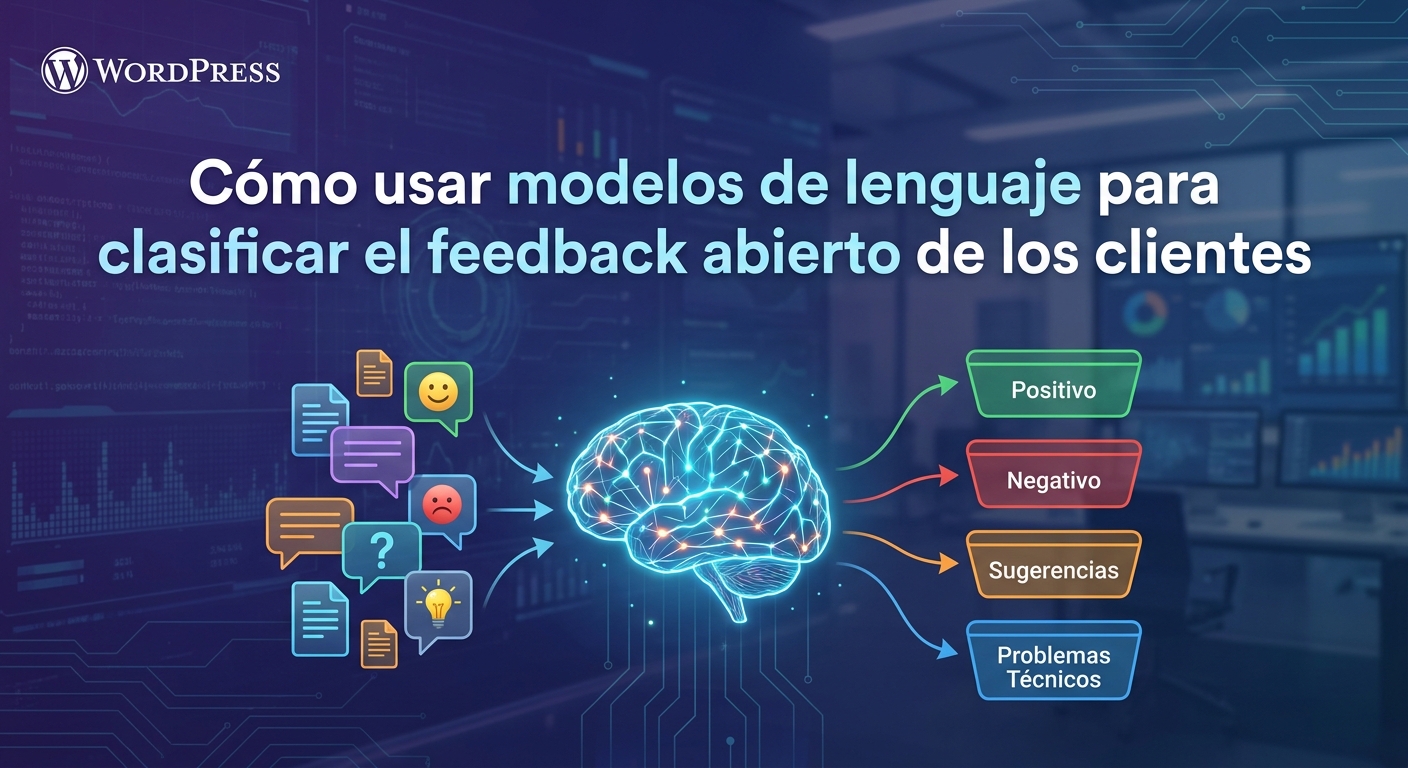
El feedback abierto de los clientes es una mina de oro de información, pero su naturaleza no estructurada a menudo lo convierte en un desafío para analizar. Sin embargo, con el avance de la inteligencia artificial, ahora es posible usar modelos de lenguaje para clasificar el feedback abierto de los clientes de manera eficiente y escalable. Esta capacidad transforma datos cualitativos en insights accionables, permitiendo a las empresas comprender mejor las necesidades, deseos y puntos de dolor de su audiencia.
La capacidad de categorizar automáticamente miles de comentarios, sugerencias y quejas permite a las organizaciones identificar tendencias emergentes, priorizar mejoras de productos o servicios y reaccionar rápidamente a problemas críticos. Implementar esta tecnología ya no es una opción, sino una necesidad para mantenerse competitivo y mejorar continuamente la experiencia del cliente.
La Importancia de Clasificar el Feedback Abierto del Cliente
El feedback no estructurado, como los comentarios de encuestas, reseñas online, tickets de soporte o menciones en redes sociales, contiene una riqueza de información que puede ser decisiva para el éxito de un negocio. Sin una clasificación sistemática, esta información permanece oculta o requiere un esfuerzo manual intensivo.
Retos del Feedback No Estructurado
Analizar manualmente grandes volúmenes de feedback abierto es una tarea ardua, propensa a errores y extremadamente lenta. Los equipos se enfrentan a la subjetividad en la interpretación, la inconsistencia en las categorías y la imposibilidad de escalar el proceso a medida que el volumen de datos crece. Esto resulta en una lenta toma de decisiones y oportunidades perdidas para mejorar.
Beneficios de una Clasificación Eficaz
Una clasificación eficaz del feedback permite a las empresas:
- Identificar Tendencias: Detectar patrones recurrentes en los comentarios de los clientes sobre productos, servicios o procesos.
- Priorizar Acciones: Saber qué problemas son los más urgentes o qué características son las más solicitadas.
- Mejorar Productos y Servicios: Utilizar insights directos para el desarrollo y la optimización.
- Monitorizar la Satisfacción: Rastrear el sentimiento del cliente a lo largo del tiempo y reaccionar a los cambios.
- Optimizar Recursos: Dirigir los equipos de soporte o desarrollo hacia las áreas de mayor impacto.
¿Qué Son los Modelos de Lenguaje y Por Qué Son Ideales para el Feedback?
Los modelos de lenguaje (LLMs) son algoritmos de inteligencia artificial entrenados en vastas cantidades de texto para comprender, generar y procesar lenguaje humano. Su habilidad para captar el contexto, la semántica y el sentimiento los hace herramientas poderosas para el análisis de feedback.
Fundamentos de los LLMs
Estos modelos, como GPT-4 de OpenAI o Gemini de Google, aprenden patrones lingüísticos complejos, relaciones entre palabras y estructuras gramaticales. Su entrenamiento masivo les permite realizar tareas como resumen, traducción, generación de texto y, crucialmente para nuestro propósito, clasificación de texto con una precisión sorprendente.
Ventajas Específicas para el Análisis de Feedback
Los LLMs ofrecen varias ventajas clave para la clasificación del feedback:
- Comprensión Contextual: Pueden entender el matiz y el contexto de los comentarios, incluso sarcasmos o expresiones idiomáticas.
- Flexibilidad: Se adaptan a diferentes idiomas y dialectos, y pueden ser ajustados para dominios específicos (ej. terminología de un sector).
- Escalabilidad: Procesan volúmenes masivos de texto en fracciones de tiempo comparado con el análisis manual.
- Reducción de Sesgos: Aunque no son completamente inmunes, pueden reducir los sesgos humanos inherentes a la clasificación manual.
- Descubrimiento de Insights: No solo clasifican, sino que también pueden ayudar a identificar temas emergentes o relaciones ocultas entre comentarios.
Guía Paso a Paso: Cómo Usar Modelos de Lenguaje para Clasificar el Feedback Abierto
Implementar un sistema de clasificación de feedback con LLMs puede parecer complejo, pero siguiendo estos pasos, cualquier organización puede empezar a extraer valor de sus datos.
1. Definición de Categorías Claras
Antes de interactuar con cualquier modelo, es fundamental establecer un conjunto de categorías bien definidas para su feedback. Estas categorías deben ser:
- Mutuamente Excluyentes: Un comentario no debe encajar en múltiples categorías principales a la vez (aunque se pueden usar subcategorías).
- Exhaustivas: Deben cubrir la mayoría, si no la totalidad, del feedback esperado.
- Accionables: Las categorías deben ser útiles para la toma de decisiones. Ejemplos: «Problemas de Rendimiento», «Solicitud de Nueva Característica», «Soporte al Cliente», «Usabilidad de la Interfaz».
Es útil revisar una muestra de feedback manualmente para refinar estas categorías antes de la implementación.
2. Preparación de los Datos
La calidad de los datos de entrada influye directamente en la precisión del modelo. Este paso implica:
- Recolección: Consolidar el feedback de diversas fuentes (encuestas, redes sociales, tickets, etc.) en un formato uniforme.
- Limpieza: Eliminar ruido como spam, duplicados, información personal sensible (PII) o caracteres especiales irrelevantes.
- Normalización: Convertir todo el texto a minúsculas, corregir errores ortográficos comunes y estandarizar abreviaturas.
3. Selección y Configuración del Modelo de Lenguaje
Existen varias opciones, desde APIs comerciales hasta modelos de código abierto:
- APIs de LLMs: Plataformas como OpenAI (GPT), Google AI (Gemini) o Anthropic (Claude) ofrecen APIs que facilitan la integración. Son potentes y no requieren infraestructura local.
- Modelos de Código Abierto: Modelos como BERT, RoBERTa o DistilBERT pueden ser auto-alojados y ajustados (fine-tuning) con sus propios datos para un rendimiento óptimo en un dominio específico. Esto requiere más experiencia técnica.
La configuración implica definir el «prompt» o la instrucción que se le dará al modelo. Un buen prompt guiará al LLM para clasificar el texto según sus categorías predefinidas. Por ejemplo: «Clasifica el siguiente feedback de cliente en una de estas categorías: [Lista de Categorías]. Solo responde con el nombre de la categoría.»
4. Implementación de la Clasificación
Una vez configurado, el modelo puede procesar el feedback. Esto puede hacerse de varias maneras:
- Procesamiento por Lotes: Enviar grandes volúmenes de feedback al LLM de una sola vez.
- Clasificación en Tiempo Real: Integrar el LLM en flujos de trabajo donde el feedback se clasifica a medida que llega (ej. un nuevo ticket de soporte).
El resultado será cada pieza de feedback asociada a una categoría, y a menudo, una puntuación de confianza para esa clasificación.
5. Evaluación y Refinamiento del Modelo
Ningún modelo es perfecto desde el principio. Es crucial evaluar su rendimiento:
- Muestreo y Revisión Manual: Revisar manualmente una muestra de feedback clasificado por el modelo para identificar errores.
- Métricas: Usar métricas como precisión, recall y F1-score si se tiene un conjunto de datos etiquetado manualmente para comparación.
- Ajuste de Prompts/Fine-tuning: Si el rendimiento no es satisfactorio, ajustar el prompt o considerar el fine-tuning del modelo con un pequeño conjunto de ejemplos etiquetados. Esta iteración es clave para mejorar la calidad de la clasificación.
Herramientas y Plataformas para la Clasificación de Feedback con LLMs
El ecosistema de herramientas para trabajar con modelos de lenguaje está en constante evolución, ofreciendo opciones para diferentes niveles de experiencia técnica y presupuestos.
APIs de Modelos de Lenguaje (OpenAI, Google AI)
Estas son las opciones más accesibles para la mayoría de las empresas. Permiten enviar texto a través de una API y recibir una clasificación sin necesidad de gestionar la infraestructura del modelo. Son ideales para prototipos rápidos y para empresas que no tienen equipos de ciencia de datos especializados. Su costo se basa generalmente en el uso (número de tokens procesados).
Plataformas de No-Code/Low-Code
Herramientas como Make (anteriormente Integromat), Zapier, o plataformas de IA conversacional como Cohere o Hugging Face Spaces permiten integrar LLMs en flujos de trabajo sin escribir código. Son excelentes para usuarios de negocio que desean automatizar la clasificación de feedback de fuentes como formularios de WordPress, hojas de cálculo o CRMs.
Soluciones Personalizadas y Open Source
Para empresas con requisitos muy específicos o que manejan datos altamente sensibles, la implementación de modelos de código abierto (como los de Hugging Face Transformers) en infraestructura propia puede ser la mejor opción. Esto ofrece el máximo control y personalización, pero requiere experiencia en ciencia de datos e infraestructura de hardware.
Mejores Prácticas y Consejos Avanzados
Para maximizar el impacto de la clasificación de feedback con LLMs, considere estas estrategias adicionales.
Iteración Continua y Monitoreo
El lenguaje evoluciona, y también lo hace el feedback de sus clientes. Monitoree regularmente el rendimiento de su modelo y esté preparado para ajustar sus categorías, prompts o incluso el modelo subyacente. El feedback es un proceso dinámico, y su sistema de clasificación también debe serlo.
Combinación con Análisis Cuantitativo
Los insights cualitativos de los LLMs son más poderosos cuando se combinan con datos cuantitativos. Por ejemplo, clasificar el feedback sobre un producto y luego correlacionarlo con métricas de uso, tasas de retención o puntuaciones de satisfacción general. Esto proporciona una imagen más completa y permite validar las hipótesis generadas por el análisis de texto.
Consideraciones Éticas y de Privacidad
Al manejar datos de clientes, es fundamental cumplir con las regulaciones de privacidad (GDPR, CCPA, etc.). Asegúrese de anonimizar o pseudonimizar el feedback cuando sea necesario. Además, sea consciente de los posibles sesgos inherentes a los modelos de lenguaje y trabaje para mitigarlos, asegurándose de que la clasificación sea justa y equitativa para todos los segmentos de clientes.
Conclusión
Los modelos de lenguaje representan una revolución en la forma en que las empresas pueden interactuar y comprender el feedback de sus clientes. Al automatizar la clasificación del feedback abierto, las organizaciones no solo ahorran tiempo y recursos, sino que también obtienen una ventaja competitiva al tomar decisiones más informadas y centradas en el cliente.
Adoptar esta tecnología es un paso crucial para cualquier negocio que busque optimizar su estrategia de experiencia del cliente y mejorar su SEO, asegurando que los productos y servicios realmente resuenen con su audiencia. Invierta en la comprensión de su cliente, y verá el retorno en lealtad y crecimiento.